使用 Playwright MCP 自动生成产品文档
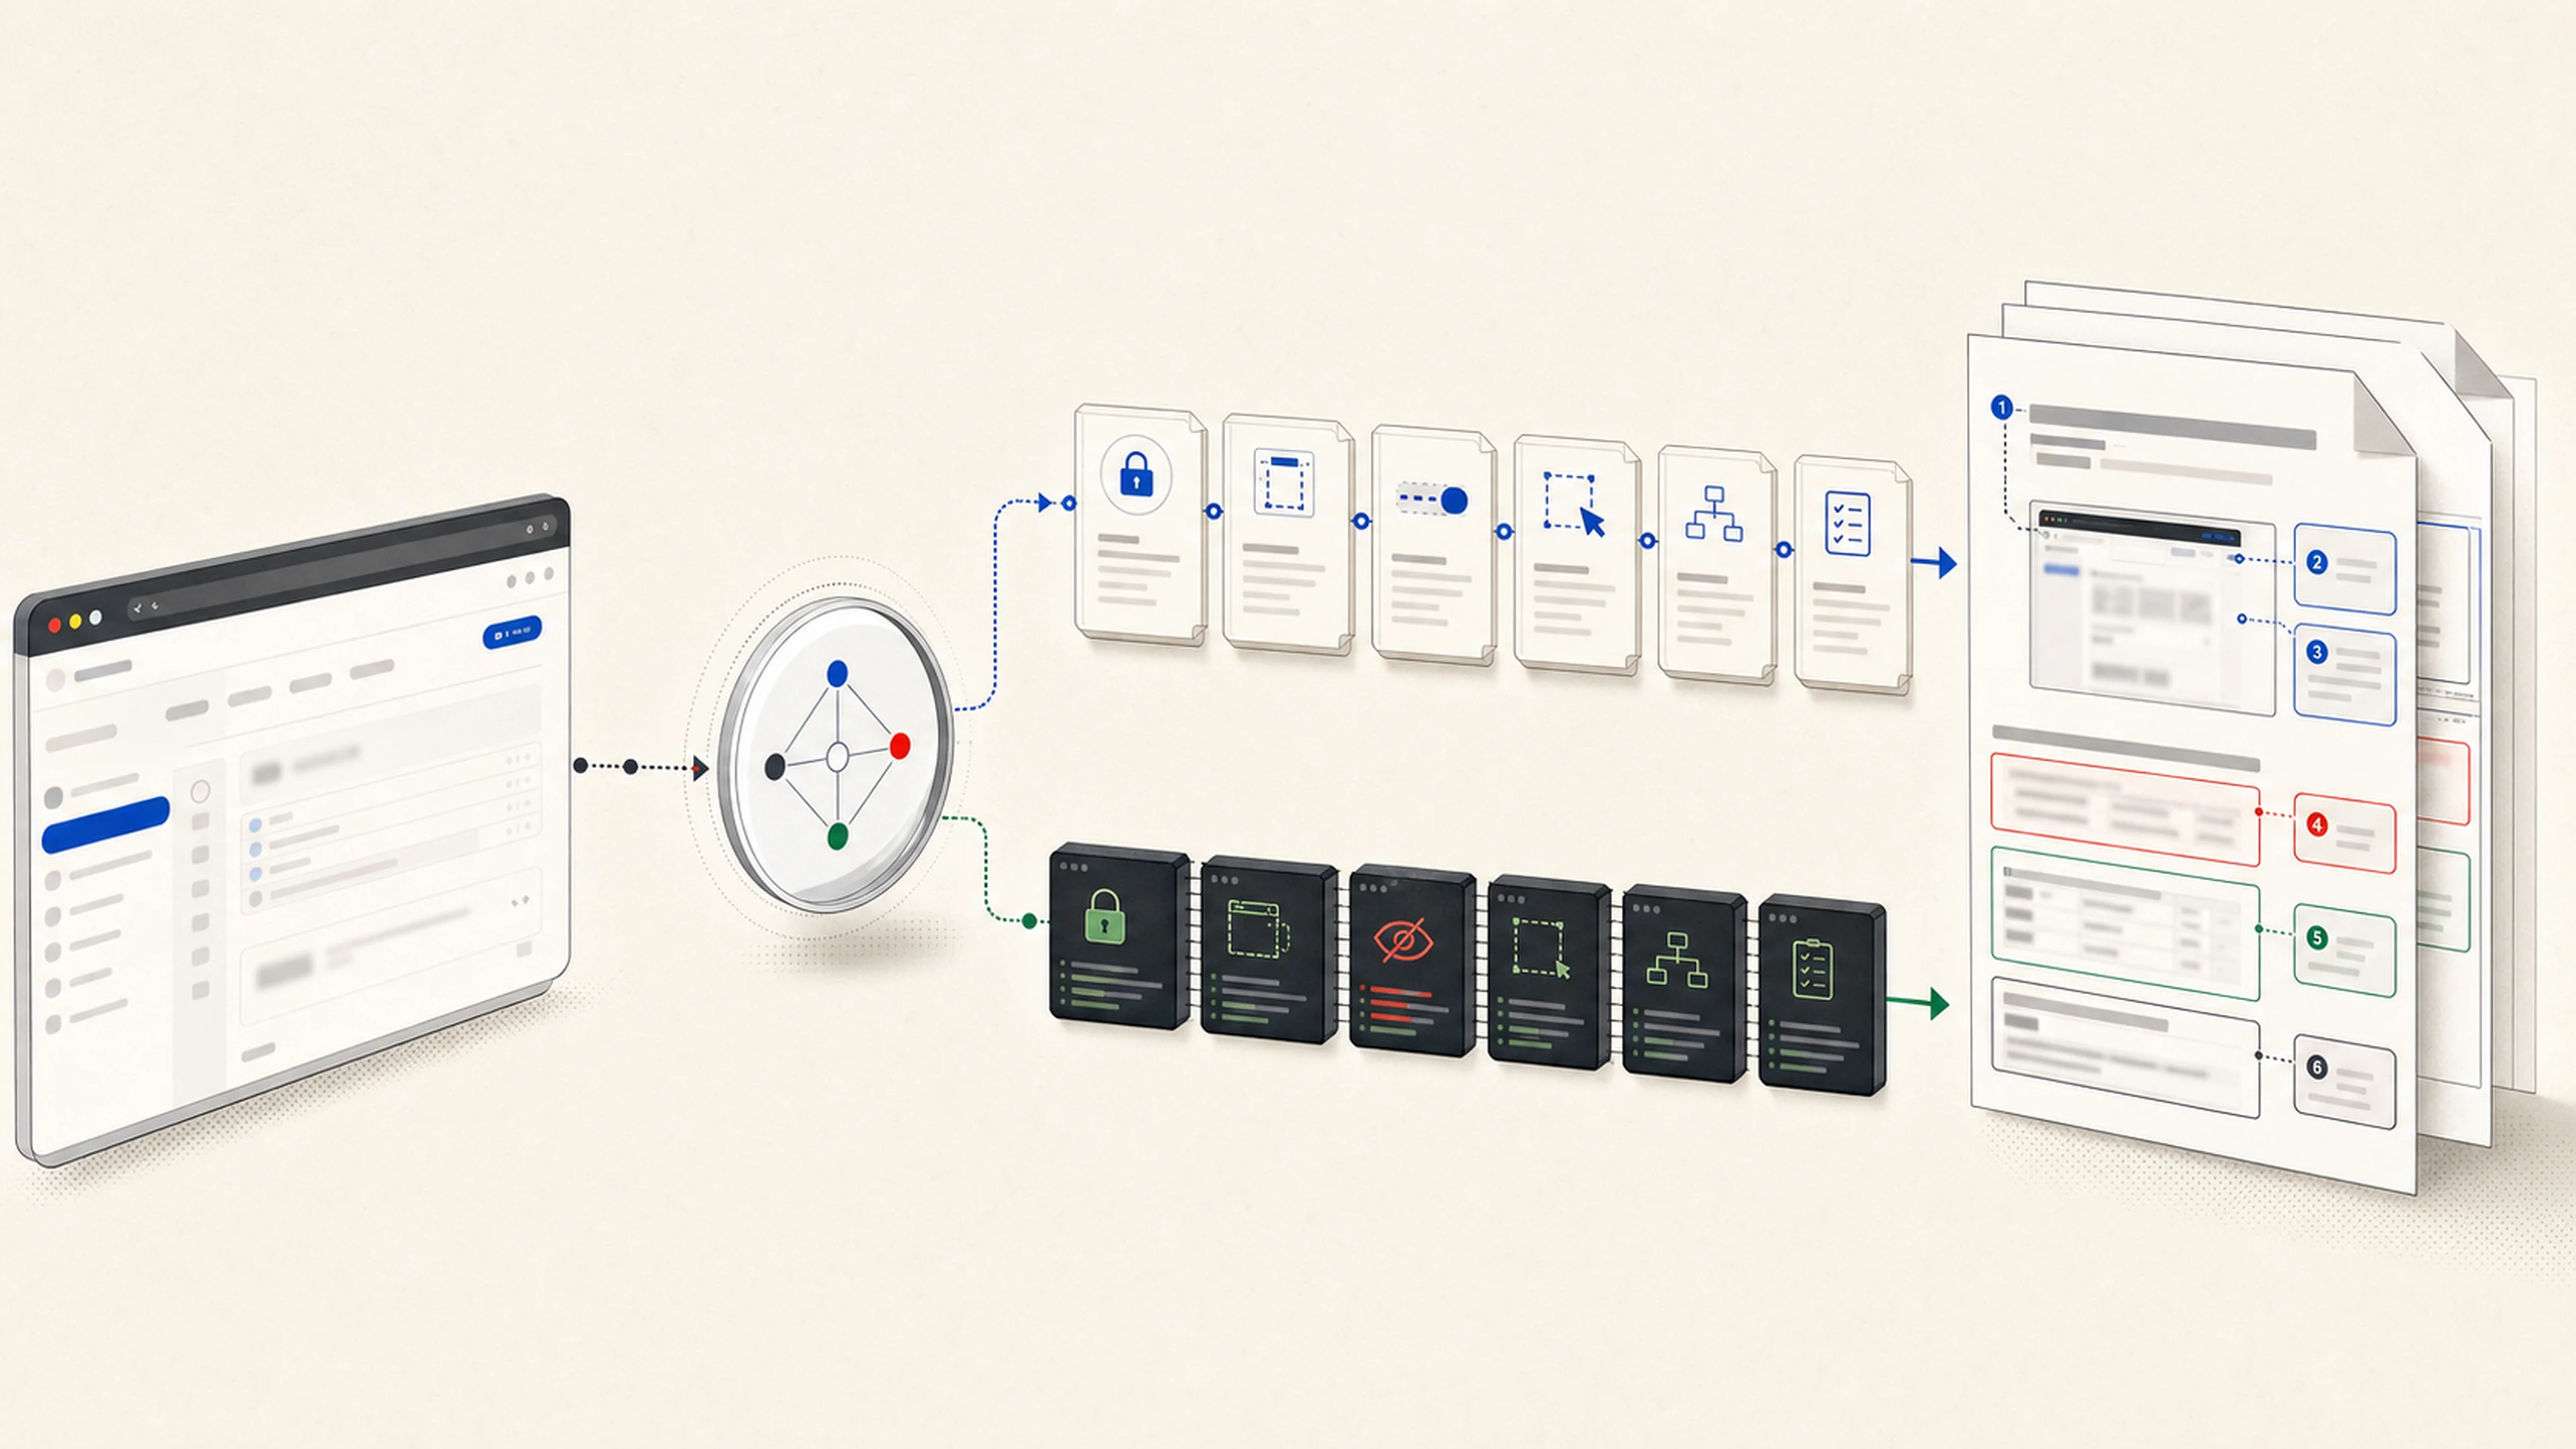
整理 Web 产品的操作文档。
正常的做法是手动打开页面,按流程一步步截图,用标注工具在图片上画框编号,再根据截图写出与之匹配的操作步骤。
但这种方式有两个问题:
- 效率低
- 如果产品跟新了内容,需要同步更新文档和标注图
能不能把这套东西直接交给 AI 来做 ?
2. 最小实验
完整跑一遍性价比太低。AI 控制浏览器本来就不快,中途遇到问题,排查路径也太长。
所以我没有让 AI 跑完整流程,而是只挑了最核心的几个动作:
登录 → 进入首页 → 截图、标注、脱敏只给入口和目标,看它自己怎么完成。目的不是完美结果,而是以小见大——用最小成本把问题暴露出来。
跑完这一小段,发现了两个问题:
-
截图的时候,页面上突然弹出一个提示弹窗,把我们要截的内容挡住了。所以需要判断这个弹窗是不是当前需要截图的对象——如果不是,就该关掉;如果弹窗本身就是业务操作的一部分,就不能关。
-
标注和脱敏的逻辑其实很“死板”。画方框就是读坐标、画 SVG,脱敏就是找文字节点、加 blur,做完再恢复。既然这么固定,直接封装成 JS 脚本就好,不需要 AI 每次自己琢磨。
一次最小实验,把两种东西分清楚了:需要现场判断的,和做法固定可重复的。
3. 开始拆分动作
根据实验中发现的问题,我把这些动作逐个拆开,发现每个动作都可以抽成两种行为模式:
- Markdown 规则:需要结合现场判断的,写成说明文档,AI 会根据当前场景读取对应的规则
- JavaScript 脚本:做法固定、输入输出明确的,封装成可调用的工具
具体来看:
-
登录 — 要不要登录、用哪种方式、验证码怎么办 → Markdown;检查登录状态、填写账号、点击登录 → JS
-
弹窗处理 — 弹窗是不是截图对象、能不能关 → Markdown;发现弹窗、匹配按钮、执行关闭 → JS
-
脱敏 — 什么数据必须挡、什么可以保留 → Markdown;加 blur、截图后恢复 → JS
-
标注 — 标哪个按钮、编号怎么排 → Markdown;读坐标、画方框、清理图层 → JS
-
页面探索 — 如何遍历菜单、识别页面结构、记录滚动模型 → Markdown;提取菜单树并持久化为 JSON → JS。探索过一次之后,后续任务直接复用这份数据,不用每次重新找菜单。
打个比方:没必要每次都让 AI 从零造一台电风扇。提前造好,告诉它开关在哪,用的时候它只需要决定“开”还是“关”。标注和脱敏就是这个电风扇——AI 只需要说“把这个按钮标上编号 1”,脚本直接就执行了。
按这个思路拆完,最终产出了 7 个 Markdown 规则(登录判断、浏览器会话、菜单提取、页面探索、截图标注、脱敏判定、文档写作)和 5 个 JS 脚本(自动登录、截图标注、文字脱敏、弹窗处理、任务管理)
4. AI 自主组合,不做流程编排
规则和脚本都拆好之后,传统思路是再写一个“编排层”把流程串起来——先做 A、再做 B、然后 C。
但 AI 本身就有理解和决策的能力,不需要被编排。
Markdown 规则和 JS 脚本就像一套乐高积木,每个都是独立的行为单元。AI 根据用户的需求,自己决定拿哪些、按什么顺序组合。
用户说“帮我看看这个产品有什么功能”,AI 自己知道要连接页面、确认登录、探索菜单,不需要截图也不用写文档。
用户说“把登录页截图标注一下”,AI 自然会跳到截图和标注的规则和脚本。
顶层 Skill 不规定执行顺序,它只做三件事: 告诉 AI 有哪些行为可用、每个行为怎么用、有哪些底线不能碰。剩下的组合方式,由 AI 根据用户意图自己决定。
这意味着同一套工具,不同用户、不同任务、不同问法,会组合出完全不同的执行路径。
5. 沉淀下来的方法
整个过程可以归纳为几步:
- 选一条最小流程让 AI 做一遍,暴露问题
- 把反复出现的行为抽象出来,拆成“判断”和“执行”
- 判断写成 Markdown 规则,执行写成 JS 脚本
- 让 AI 自主组合这些行为,不做流程编排